タグ: inference
vLLM v0.28.0、KVキャッシュをディスクにも逃がせるように
NVIDIA、エッジ向け「Jetson Orin Nano 2」を発表 - 推論性能2倍、提供は2027年上期の見込み
OpenAI、自社推論チップ「Jalapeño」の測定結果を公開 - 電力あたり1.5〜1.9倍、遅延1.7〜3.6倍改善と主張
NVIDIA、推論アクセラレータ「Groq 3 LPX」を量産開始 - 毎秒3,400トークンの計測条件も公開
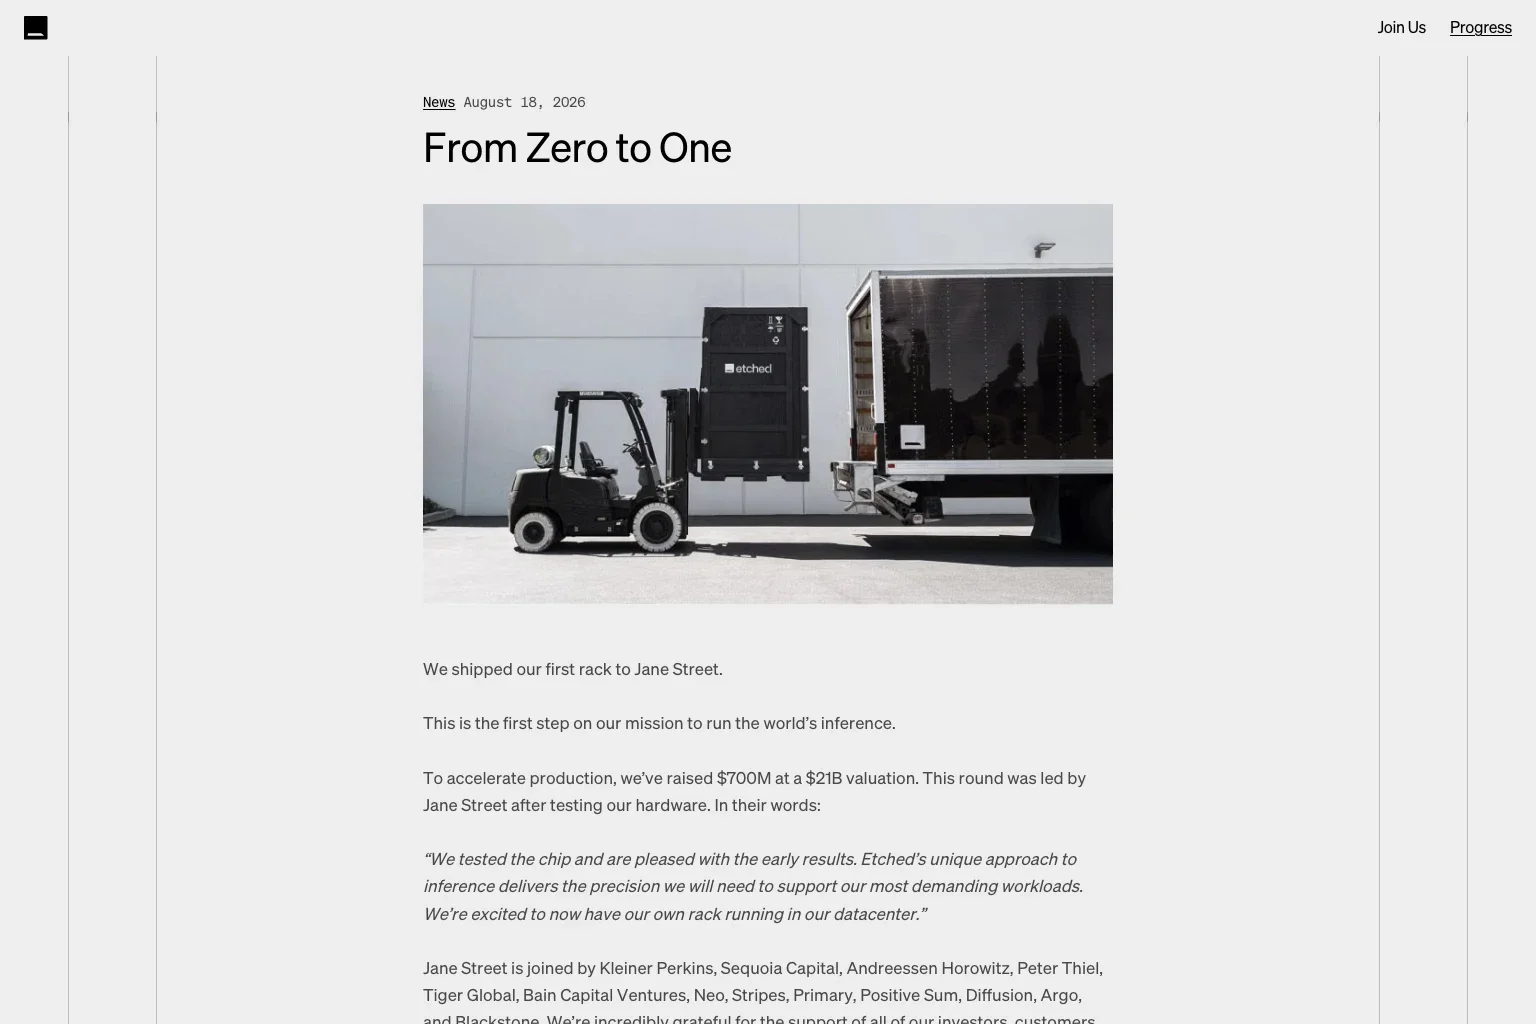
Etched、7億ドルを調達し評価額210億ドルに - 初号ラックをJane Streetに出荷
Groq、3億5,000万ドルのシリーズA - 評価額35億ドル、資金の使い道はNVIDIAクラスタ
OpenAI API に「Ultrafast」階層 - GPT-5.6 Sol を最大14倍速で動かす、供給はCerebras
Mistral、推論の実行地域を選べるRegional Endpointsを一般提供 - 欧州で最大1GWのコンピュート計画も

推論チップが「担保」になった - General Compute、SambaNova製チップで最大4億ドルの融資枠
