OpenAI、型付きの答えだけを返す「Decisions API」をベータ公開 - 確率・選択・採点の3型、課金は入力だけ
OpenAIが2026年10月6日、テキストや画像を評価して型付きの答えだけを返すDecisions APIをベータ公開した。モデルはgpt-6-lunaのみで、答えは確率(predicate)・選択(choice)・採点(score)の3種類。料金は入力100万トークンあたり$0.10で、出力とキャッシュの課金はない。
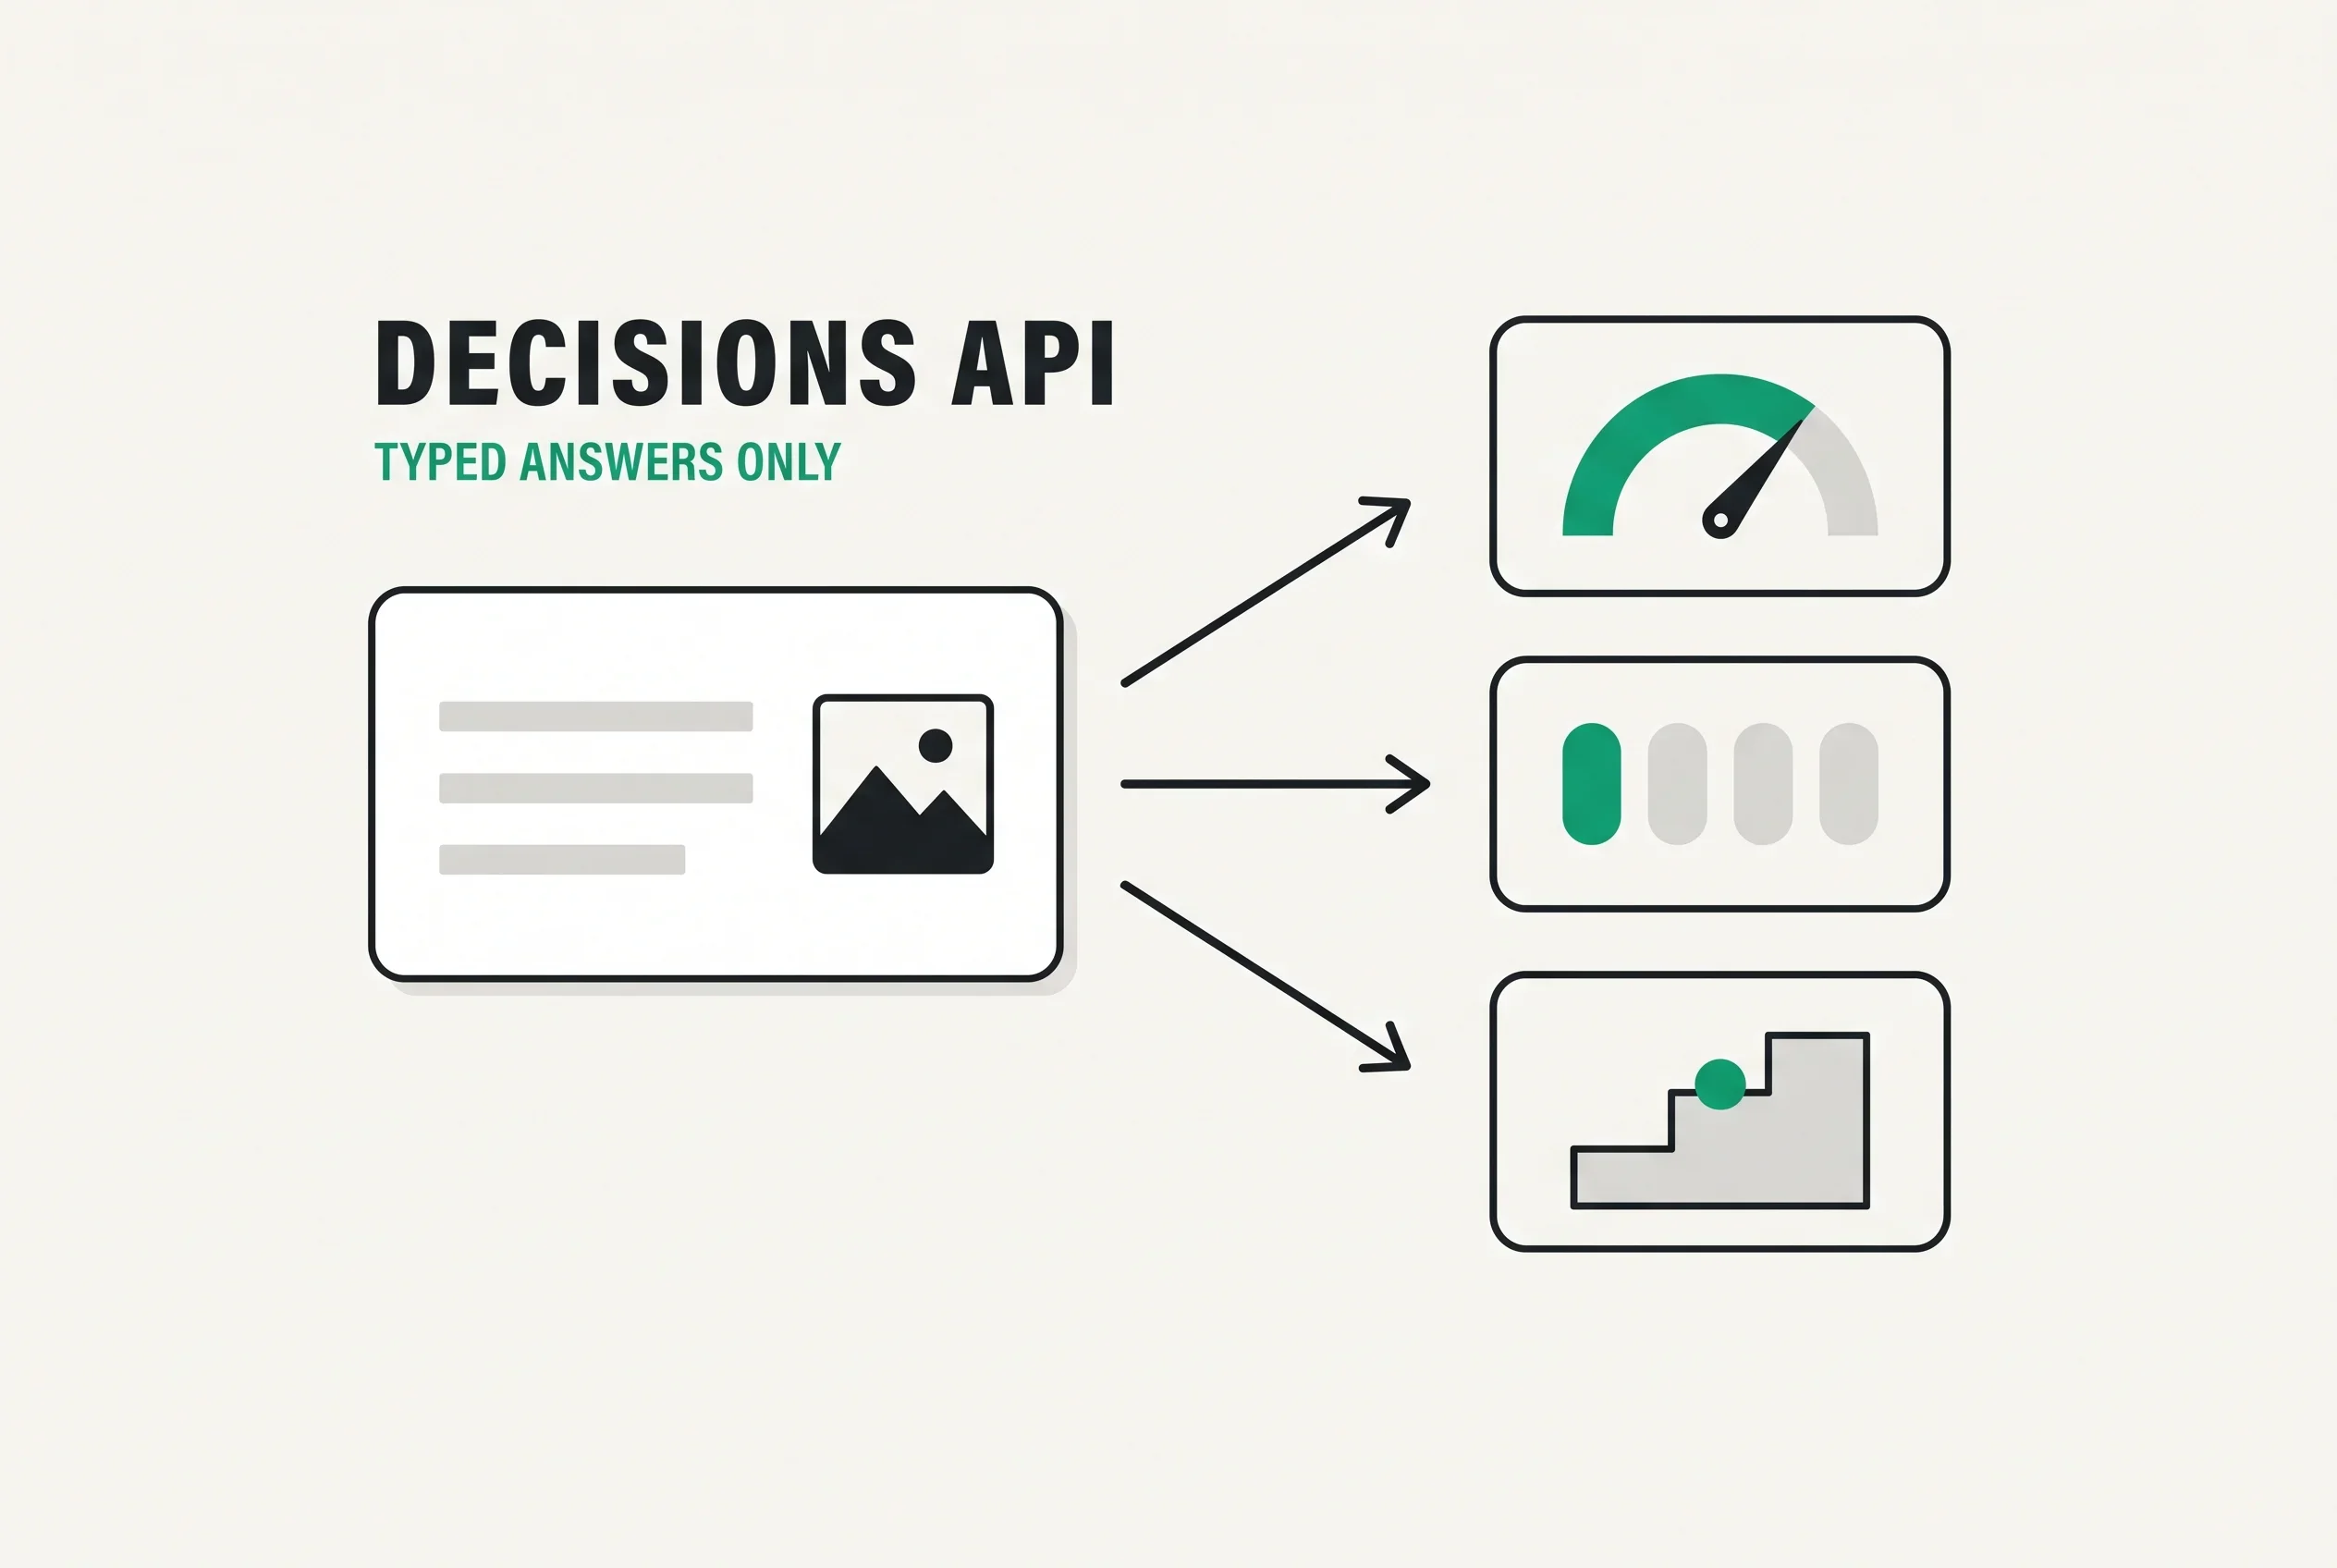
OpenAIは2026年10月6日、Decisions API をベータとして公開した2。文章を生成するAPIではない。テキストや画像を渡して質問を投げると、「条件に当てはまる確率」「決められた選択肢のどれか」「段階評価のスコア」のいずれかが型付きで返ってくる。エンドポイントは専用の POST /v1/decisions で、使えるモデルは現時点で gpt-6-luna だけだ1。
OpenAIはResponses APIより約10倍速く答えを返すと説明しているが、ドキュメントにもchangelogにも計測条件は書かれていない。料金は入力100万トークンあたり$0.10で、払うのは入力トークンの分だけになる。パブリックベータの段階で、GAは数週間以内を見込むとしている。
答えは3つの型に限られる
リクエストは、評価に使うモデル(model)、判断材料となる入力(input)、聞きたいこと(questions)の3要素で組む。質問ごとに型を指定し、型によって返り値の形が決まる1。
- predicate: 条件が真かどうか。0から1の確率で返る。ドキュメントの例は、商品写真にひび・裂け・へこみといった目に見える損傷があるか
- choice: こちらが渡した選択肢から1つ選ぶ。例は「二重に請求された」という苦情を billing / technical / shipping / other のどの部署に回すか
- score: 順序のある段階で採点する。返る値は段階の番号(0始まり)を確率で重み付けした平均なので、段階と段階の間の値にもなる。不具合の深刻度を3段階で評価し、確率が0.1・0.7・0.2なら1.1、という例が載っている
choiceとscoreは選択肢ごとの確率の配列と、別に confidence も返す。どの値で人の確認に回すかは、自分のアプリのラベル付きデータを使い、誤検知と見逃しのどちらが高くつくかで決めるよう案内されている。choiceで選択肢が入力を網羅しきれない場合には、other のような受け皿を入れておくことも勧めている。
独立した質問は1回のリクエストにまとめて送れ、質問ごとに型を変えてよい。前の答えによって次の質問が変わる場合は、リクエストを分ける必要がある。
料金は入力のみ、画像はbase64だけ
料金の書き方は通常のモデルと違う。/v1/decisions で gpt-6-luna を使う場合、入力は100万トークンあたり$0.10で、キャッシュの読み取り・書き込みにも出力トークンにも課金はないとされている1。地域処理の割増と長いコンテキストの入力単価の倍率は適用され、同じ gpt-6-luna でもDecisions API以外のリクエストは通常の料金表に従う。
9月22日にGPT-6 Lunaが公開されたときの標準料金は、入力$0.10・キャッシュ入力$0.01・出力$0.50だった2。入力単価の数字は同じで、Decisions APIでは出力とキャッシュの区分がなくなった形だ。Decisions APIでは、請求額を左右するのは入力のトークン量になる。
制約もある。画像はインラインのbase64データURLでしか渡せず、HTTP/HTTPSの画像URLや file_id は受け付けない1。オブジェクトストレージのURLを渡して画像を判定させている既存の処理は、そのままでは載せ替えられない。
データ管理の面では、対象となる顧客にはZero Data Retention(ZDR)とHIPAA用途に対応し、データレジデンシーと地域処理は米国と欧州(EEA+スイス)で使える。保存方針と処理地域を先に確認する必要がある組織にとっては、ベータの段階でこの範囲が明記されている点は検討の材料になる。
「決定モデル」の流れとStrands Decider 2B
TechCrunchは、9月にTypeSafe AIのJevが出て以来、テキストではなく結果の確率を出力する決定モデルがAI業界の話題になり、OpenAIとAmazonからも競合するモデルが続いたと書いている3。同じ10月6日にはMusubiが、コンテンツモデレーション向けの決定モデルPolicyLM-1.7Bをオープンウェイトで発表した。なおOpenAIのドキュメント自体は、Decisions APIを「決定モデル」とは呼んでいない。
自サイトでは10月4日に、strands-labsが10月1日に公開したStrands Decider 2Bを取り上げた。答えの種類は選択・yes/no・採点の3つで、Decisions APIの3型と近い。違うのは置き場所である。Strands Decider 2Bは19億パラメータの重みをApache 2.0で公開し、手元のGPUやCPUで動かせるもの。Decisions APIはOpenAIのクラウドでgpt-6-lunaを呼ぶもので、モデルを選ぶ余地は今のところない。
信頼度の扱いも比べどころになる。strands-labsは、決定モデルが判断ごとに信頼度を返す点を挙げ、これはフロンティアLLMの推論APIでは得られないとしていた。Decisions APIはpredicateで確率を、choiceとscoreで確率分布とconfidenceを返す1。どちらを選ぶかは、データを外に出せるか、GPUを運用できるか、判定の量がどれくらいかで分かれるだろう。
Structured Outputsとの線引き
ドキュメントは他の機能との使い分けも示している。答えが3つの型のどれかで済むならDecisions API、独自のJSONスキーマに沿ったオブジェクト(抽出した項目や説明文など)を生成したいならResponses APIのStructured Outputs、ツールを引数付きで呼ばせたいならfunction calling、という整理だ1。
いまStructured Outputsで {"category": "billing"} のような1項目だけを返させている箇所は、移し替えの候補になると考えられる。逆に、判定の理由を文章で残したい、複数の項目を一度に抜き出したいといった用途は、Decisions APIの守備範囲の外にある。音声との組み合わせも案内されていて、Live APIのclient delegationと組み合わせ、話しかけられた依頼から実行するアクションを選ぶ使い方がガイドの末尾で紹介されている。
ベータの間は対応モデルが1つだけで、速度についての公式の説明は計測条件の付かない「約10倍」にとどまる。分類やルーティングをLLM呼び出しで組んでいるなら、Playgroundで自分の入力を流し、既存の構成と速度・精度・請求額を並べて確かめるのが先になる。GAのタイミングで料金や対応モデルが変わるかどうかも、見ておきたい点だ。
Sources
- Decisions - OpenAI APIドキュメント(Decisions APIガイド)
- Changelog - OpenAI API changelog(2026年10月6日のDecisions API公開、9月22日のGPT-6 Luna公開)
- How AI decision models could change content moderation - TechCrunch(2026年10月6日)
この記事は役に立ちましたか?
ありがとうございます!
受け取りました。ありがとうございます!