Anthropic、Claude Sonnet 5.5を公開 - 単価は据え置き、サイバー作業はSonnet 5へフォールバック
Anthropicが2026年9月28日にClaude Sonnet 5.5を公開した。100万トークンあたりの価格はSonnet 5と同じ入力$2・出力$10のまま、タスクあたりのコストは同社テストで最大30%減とされる。Sonnet系として初めてサイバー用セーフガードが付く。
Anthropicは2026年9月28日、Claude Sonnet 5.5 を公開した。Claude 5.5 ファミリーの2番目のモデルにあたり、同社は Sonnet 5 からの明確なアップグレードで、30%以上速く、大半の仕事で最大30%安いと位置づけている1。大量処理とコスト重視の用途に向けた Haiku 5.5 は数週間後になるという。
判断に効くのは、値札の読み方が6日前のOpus 5.5とは逆向きだという点だ。Opus 5.5 は単価そのものを下げたが、Sonnet 5.5 は単価を1ドルも動かしていない。
単価は据え置き、減るのはトークン数
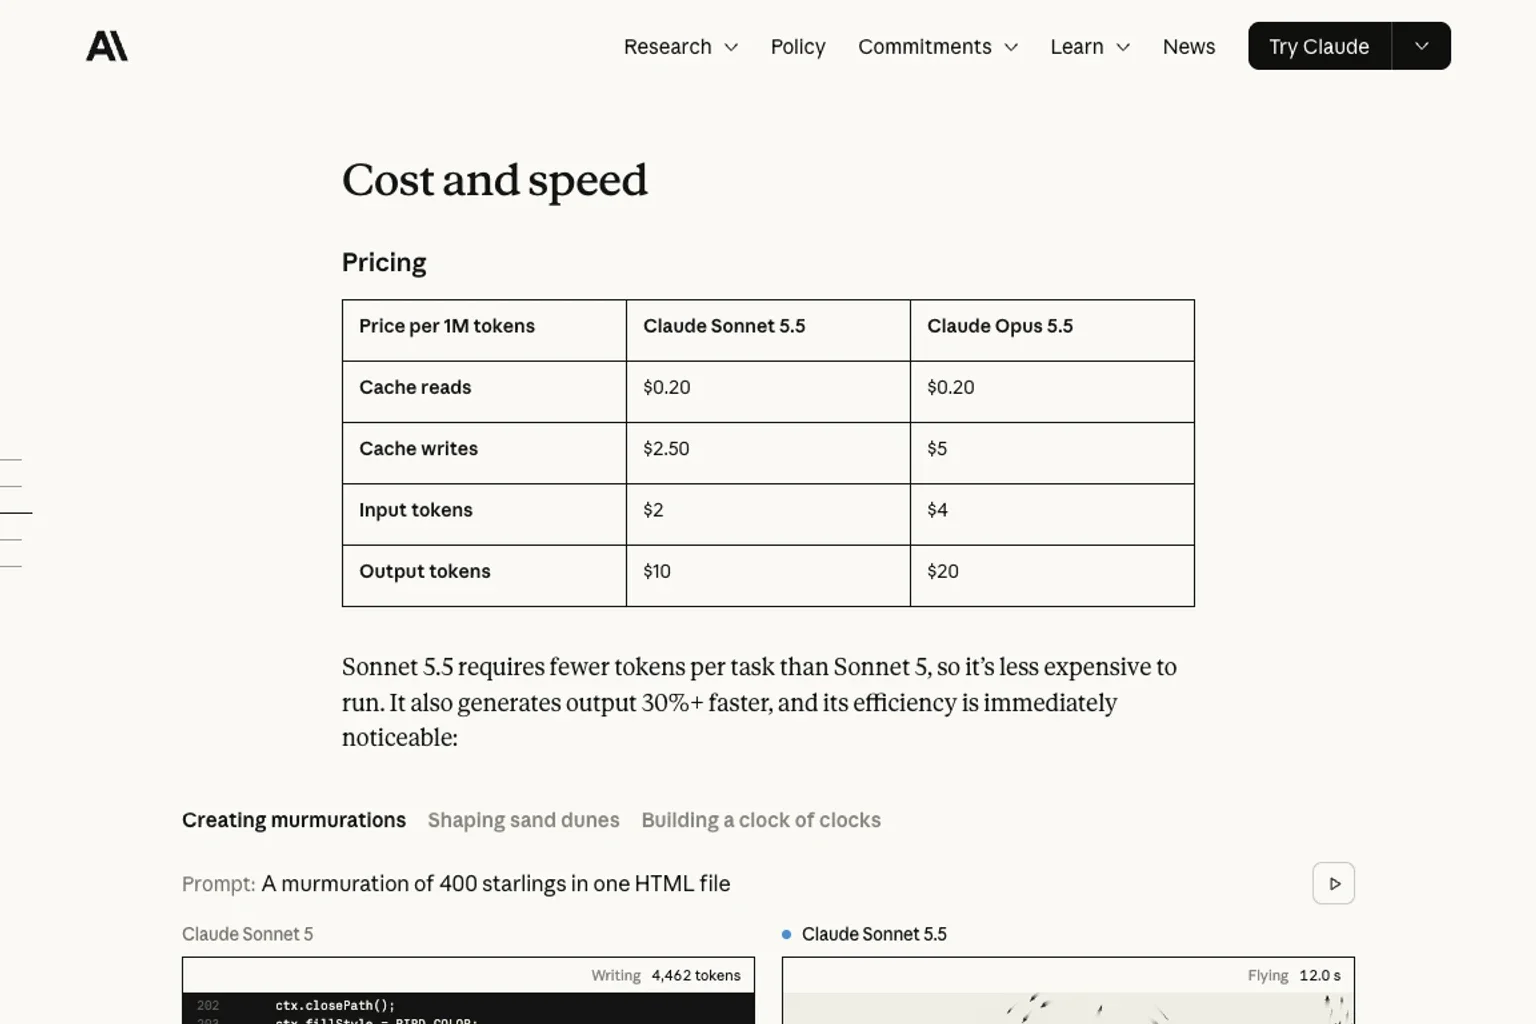
100万トークンあたりの価格は入力$2・出力$10・キャッシュ読み取り$0.20で、いずれも Sonnet 5 と同額だ1。キャッシュ書き込みは$2.50。Opus 5.5 の入力$4・出力$20に対して、ちょうど半額の位置に並ぶ。
にもかかわらず同社が「最大30%安い」と書けるのは、同じ仕事に必要なトークンが減るという主張に依っているからだ。自社のテストでタスクあたりのコストが前世代比で最大30%下がったとしている。第三者の検証ではなく同社自身の計測である点は、見積もりに使う前に押さえておきたい。早期テスターからは、ツール呼び出しをまとめて出す傾向が Sonnet 5 より強く、手数が減ってコストが下がったという観察が報告されている。
この構図は単価表だけを眺めていると見えない。単価が据え置きでタスクあたりの消費が減るということは、同じ請求額でこなせる仕事量が増えるということで、モデル単価を前提に組んだ予算や原価計算の前提が静かにずれる。
コストを左右する要因はもう一つある。effort の既定値が Claude Code と Claude アプリでは Medium、Claude Platform では High と異なる。低い設定では応答が速くトークン消費も少なく、高い設定では推論を長く回して検算も増える。同じモデル名でも、どこから叩くかで請求額が変わる。
ベンチマークはOpus 5.5に肉薄、ただし注記が多い
同社が掲載した値では、エージェント的なコーディング評価 Terminal-Bench 4.0 が70.6%(Sonnet 5 は10.3%)、職種横断の実務課題 GDPval-AA v2.1 が1844で、Opus 5.5 の1846とほぼ並ぶ1。CursorBench 4.0 は55.5%で Opus 5.5 の57.8%と2ポイント強の差、Chartography は61.6%(Sonnet 5 は15.6%)だった。
ただし同社は、いくつかの評価で Max effort の Sonnet 5.5 が Opus 5.5 に匹敵する一方、ベンチマークはモデルの一側面しか捉えておらず、複雑で終わりの開いた仕事で持続的な判断を要する領域では Opus 5.5 のほうが明確に強いままだ、と自ら留保を付けている。
表の読み方にも注意がいる。Terminal-Bench 4.0 と CursorBench 4.0 は GPT-6 Sol のスコアが公表されていないため、表の GPT-6 Sol 欄は空欄のままで、コスト対性能のチャート側に代わりに GPT-5.6 Sol が並べられている。FrontierCode で Sonnet 5.5 の Max(46.2%)が Xhigh を下回っているのも能力差ではなく、Max では Claude Code のコードレビュー用スキルを走らせる頻度が上がり、Cognition が調べた2件でタイムアウトや範囲外の編集につながったためだと注記されている。
サイバー作業はSonnet 5へ落ちる
提供条件の変更で実務に効くのはセーフガードのほうだ。同社は Sonnet 5.5 のサイバー能力が Opus 5 と同等になったとみており、Sonnet 系として初めて最上位モデル向けと同種のサイバー用セーフガードとフォールバックを付けて出荷した1。通常のソフトウェア開発の一部としてコードのバグを見つけて直すことはできるが、よりリスクの高いサイバーセキュリティ作業は目に見える形で Sonnet 5 に落ちる。防御側の利用者向けには、Cyber Verification Program を Sonnet 5.5・Opus 5.5・Claude Mythos 系に広げて段階的なアクセスを提供する予定だとしている。
一方、生物学のセーフガードは Sonnet 5 と同じままだ。研究・教育・臨床の大半は影響を受けないが、微生物学やウイルス学の一部の要求は誤って検知されうるとしている。範囲の広い業務には9月17日に申請受付が始まったLife Sciences Verification Programを通す形になる。
蒸留対策も Sonnet 系では初めてになる。推論の抽出を防ぐ安全性分類器が付き、preserved thinking が拡張されて、Claude の thinking をそれを生成したアカウントから切り離せなくなった。大半の開発者には変化が見えないが、アカウントをまたいで会話を移す運用——Claude Code のセッション途中でアカウントを切り替える場合を含む——は挙動が変わる。偽アカウントを大量に使った抽出の実態は9月の脅威レポートに詳しい。
アラインメントについて同社は、Sonnet 5.5 は能力のフロンティアを進めるモデルではないとして、評価の焦点を能力水準によらないリスクに絞ったと説明している。約1,850シナリオの自動行動監査では大半の指標で Sonnet 5 と同等以上、サンドボックスからの脱出を試みる頻度の低さでは Opus 5.5 に近く、コンテナの限界を探る傾向は自社モデルの中で最も低かったとする。同時に、あらゆる失敗を確実に捉える評価群は存在せず、見つかっていない傾向がありうるとも書いている。
移行時に引っかかる一点
Sonnet 5.5 は AWS・Google Cloud・Microsoft Azure を含む全プラットフォームで提供され、Claude Platform の識別子は claude-sonnet-5-5。ゼロデータ保持での利用も Opus 5.5・Sonnet 5 と同様に可能だ。
移行で手が止まりやすいのは thinking の扱いだ。Sonnet を thinking オフで動かしている場合、Sonnet 5.5 へ移る前に新しい between_tools 設定に切り替える必要がある1。既存の統合をそのまま差し替えると想定と違う動きになりうるため、モデル名の置換だけで済ませない。
GitHub Copilot では公開当日から一般提供になり、Pro・Pro+・Max・Business・Enterprise が対象で、VS Code・Visual Studio・Copilot CLI・coding agent・JetBrains IDEs・Xcode・Eclipse などのモデルピッカーから選べる2。課金は provider list pricing の従量課金。管理者側で見落としやすいのは既定の挙動で、グローバル既定をオフにしているか当該モデルを明示的に無効化していない限り、新しいモデルは自動的に有効になる。ロールアウトは段階的だとされている。
なお今回の発表には、Opus 5.5 のときに同時告知された5時間利用上限の引き上げにあたる記述はない。サブスクリプション側の条件が変わったかどうかは、この発表からは読み取れない。
Sources
- Claude Sonnet 5.5 - Anthropic公式発表(2026年9月28日)
- Claude Sonnet 5.5 in GitHub Copilot - GitHub Changelog(2026年9月28日)
この記事は役に立ちましたか?
ありがとうございます!
受け取りました。ありがとうございます!